Universitetsavisen
Nørregade 10
1165 København K
Tlf: 21 17 95 65 (man-fre kl. 9-15)
E-mail: uni-avis@adm.ku.dk
—
Videnskab
Kollaps — Et nyt studie fra Datalogisk Institut viser, at brugen af sprogmodeller til videnssøgning risikerer at føre til et videnskollaps. For AI’s svar er mindre diverst og dybdegående end en almindelig googlesøgning, og det har konsekvenser.
Spørger du Chatten i stedet for at google, når du skal vinde diskussionen hen over aftensmaden? Så er du bestemt ikke alene.
Om studiet
I studiet What and Whose Knowledge? Measuring Epistemic Diversity in Large Language Models undersøgte forskere fra Københavns Universitet, Aalborg Universitet, Stanford University, University of Colorado Boulder og University of Texas Austin 27 store sprogmodeller fra virksomhederne OpenAI, Meta, Google og Alibaba.
Forskerne testede 155 emner med tilknytning til 12 forskellige lande. Sprogmodellerne genererede cirka 1,7 millioner svar og omtrent 70 millioner enkeltstående udsagn. Små modeller genererer mere diverst indhold end større modeller og nyere modeller er bedre end ældre. Sammenlagt er de alle dårligere end klassiske søgemaskiner.
Kilde: KU.dk
For sprogmodellerne er efterhånden svære at komme uden om, når vi skal finde et hurtigt svar på et spørgsmål. Selv Google har implementeret en AI-opsummering, som dukker op som det første, når vi bruger søgemaskinen.
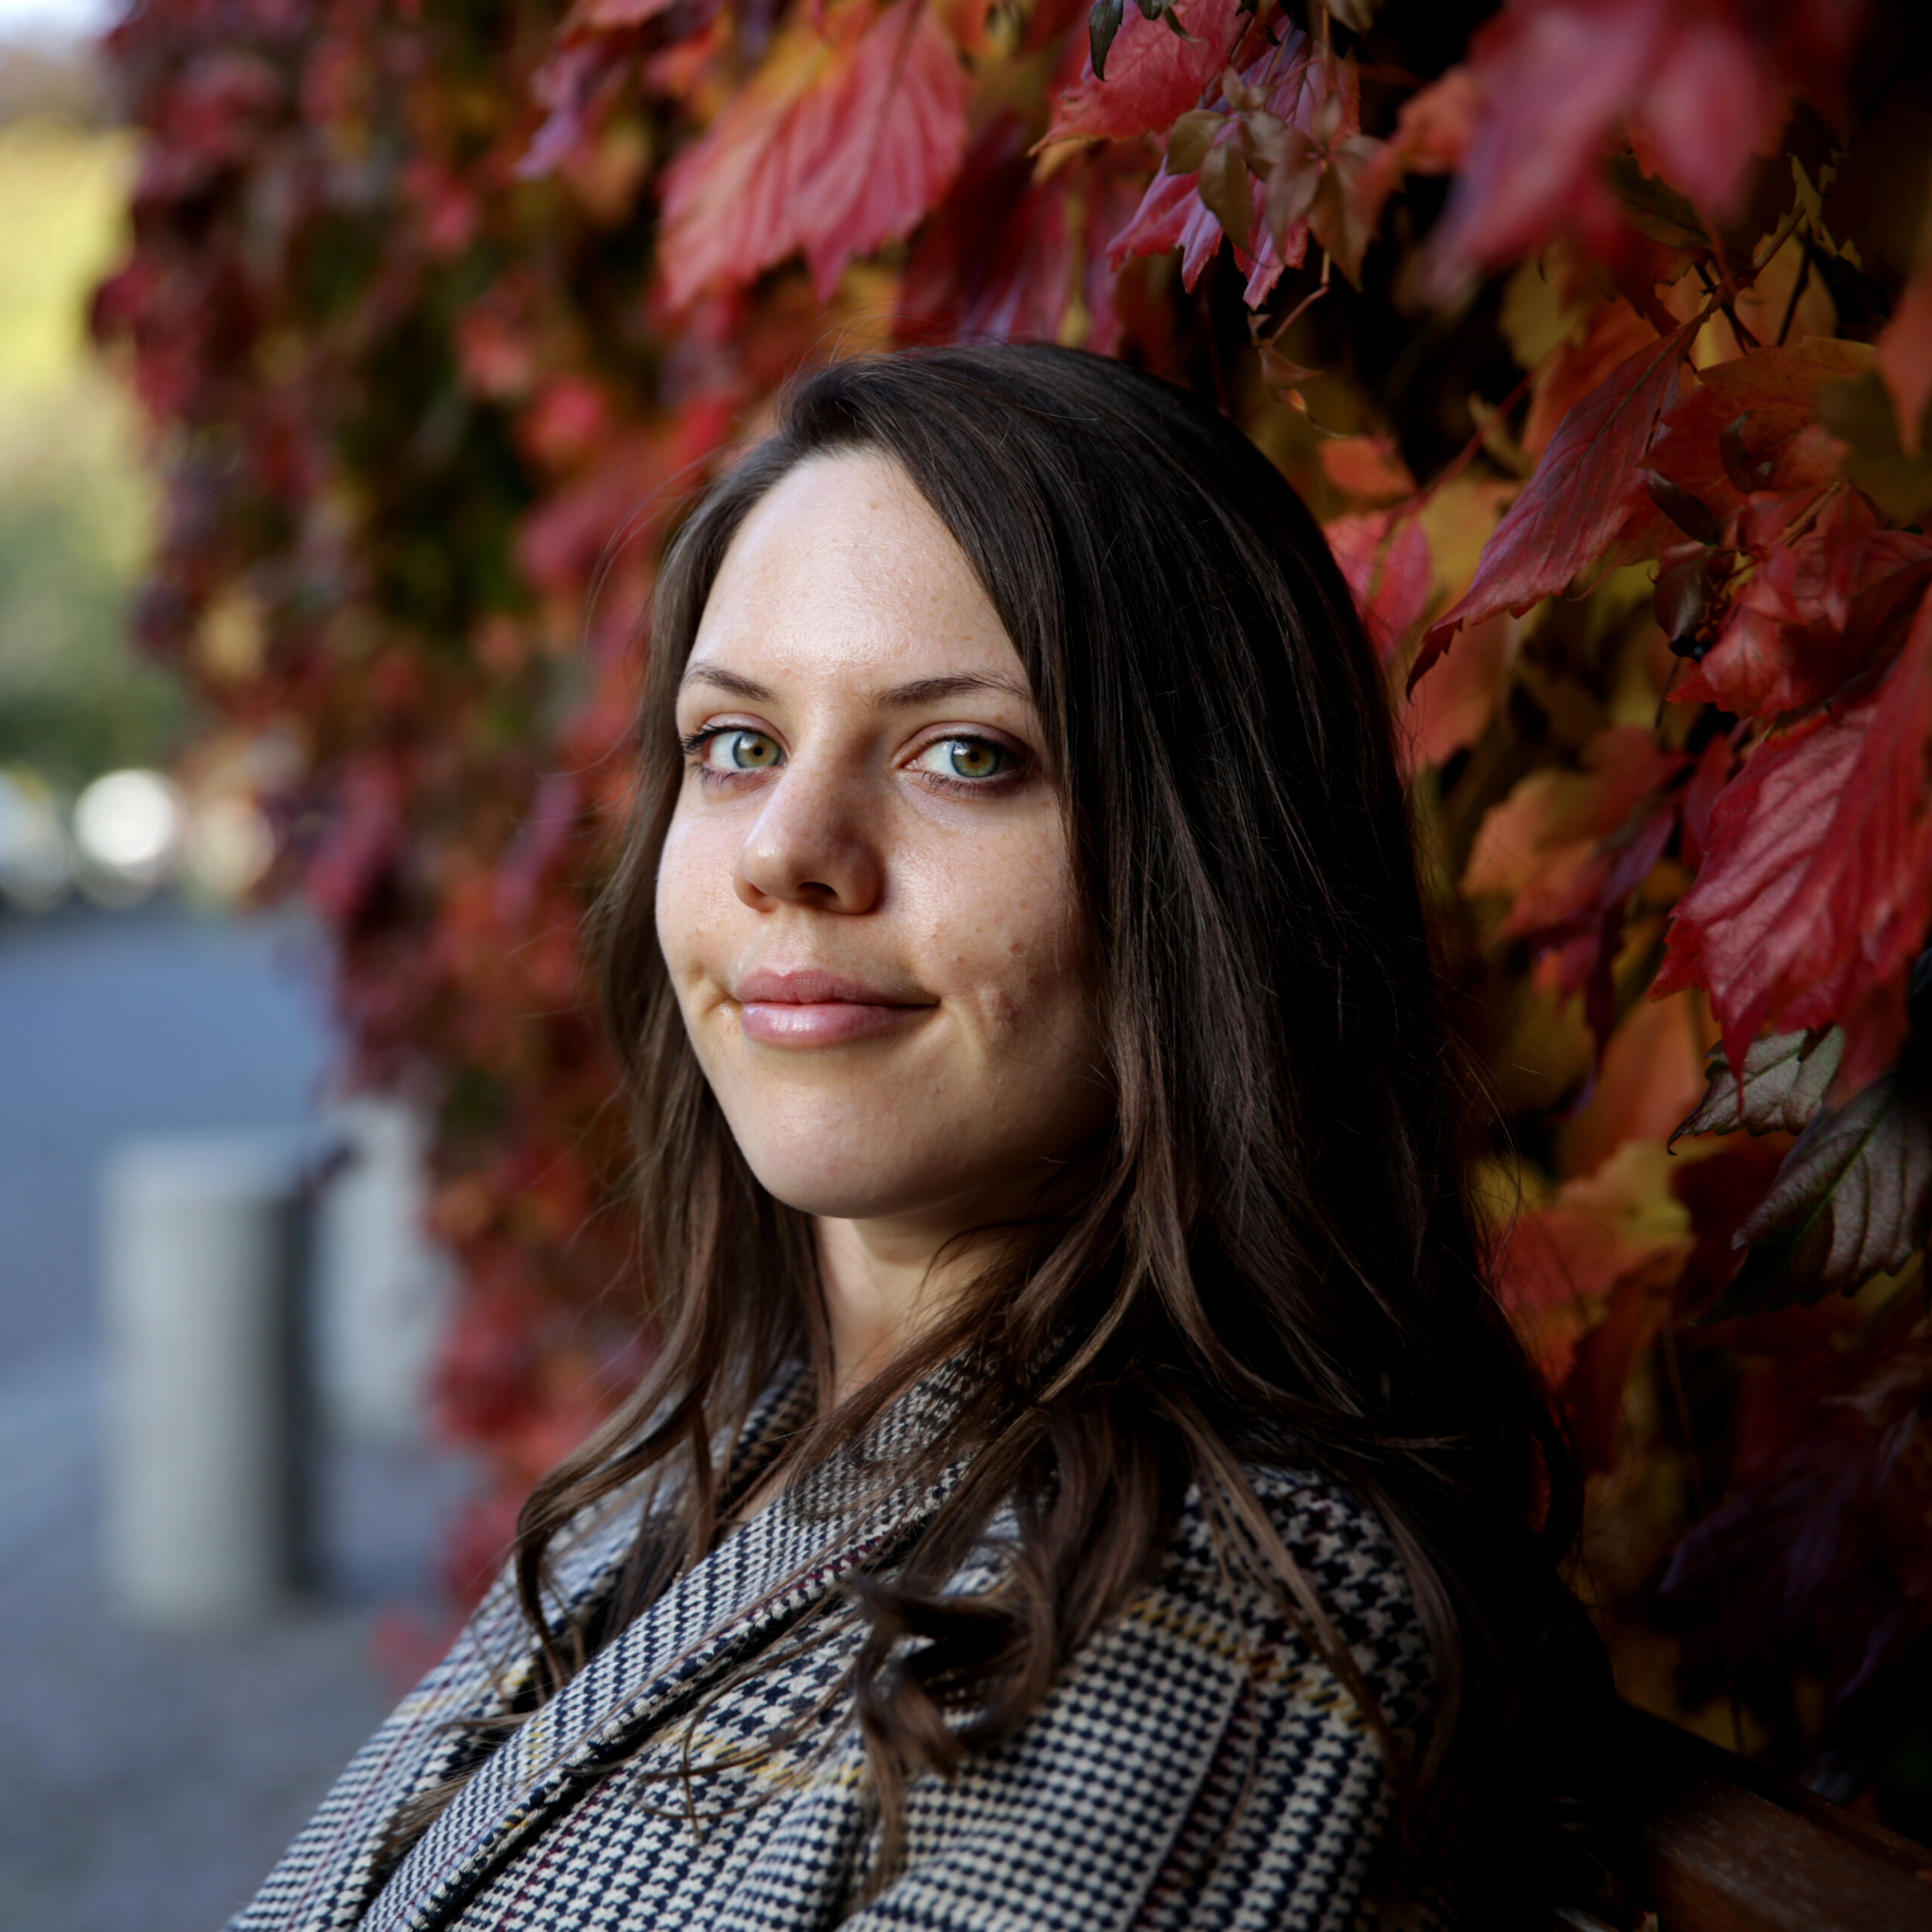
Men det er ikke helt problemfrit, viser det nye studie What and Whose Knowledge? Measuring Epistemic Diversity in Large Language Models af blandt andet KU-professor Isabelle Augenstein. Forskerne har undersøgt, hvor gode 27 forskellige sprogmodeller er, til at give brede svar på forskellige spørgsmål.
LÆS OGSÅ: Forsker: »AI bliver aldrig en bæredygtig teknologi«
I studiet fandt de frem til, at selvom de nye sprogmodeller er bedre end de gamle, er selv de bedste sprogmodellerne 18 til 19 procent dårligere end en almindelig internetsøgning. Og det får advarselslamperne til at blinke – for hvis sprogmodellerne overtager for meget af vores videnssøgning, kan det i sidste ende føre til det, forskerne kalder for et videnskollaps. Det betyder, at adgangen til den oprindelige mangfoldighed af menneskelig viden i stigende grad bliver formidlet gennem et mere og mere snævert udvalg af synspunkter:
»Hvis et emne ikke er tilstrækkeligt populært, betyder det i sidste ende, at folk enten slet ikke kan finde viden om det, de undersøger, eller at den viden, de får, er meget mangelfuld,« siger Isabelle Augenstein til Uniavisen.
Isabelle Augenstein er professor og viceinstitutleder på Datalogisk Institut (DIKU). Hun begyndte at forske i AI længe før, det blev tidens hotteste emne – dengang Google Translate var det mest synlige eksempel på sprogmodellers potentiale. Derfor var Isabelle Augensteins forældre også meget skeptiske, da hendes valg af uddannelse tilbage i 2008 faldt på en bachelor i AI:
»De tænkte, jeg aldrig ville få et job med min uddannelse. For dem lød AI som noget science fiction, der aldrig ville komme til at fungere i virkeligheden.«
I dag er Isabelle Augensteins forskningsområde i rivende udvikling, og professoren bruger det meste af sin tid på at forske i de sociale implikationer, der er ved brugen af sprogmodeller.
I det nye studie har Isabelle Augenstein og kollegaer undersøgt, hvor stor forskel der er på den viden, man får, når man bruger en sprogmodel i stedet for en søgemaskine. Forskerne blev inspireret til projektet, efter de var faldet over et tidligere studie, hvor forfatterne trænede AI-modeller på dens egne svar, og derigennem simulerede et ’videnskollaps’:
LÆS OGSÅ: Lektor: KU skal se AI-virkeligheden i øjnene
»Deres studie var meget teoretisk. Derfor tænkte vi, det ville være spændende at undersøge, om der allerede nu er sket et videnskollaps ved at kigge på både gamle og nye sprogmodeller,« siger hun.
I studiet tog forskerne både gamle sprogmodeller fra 2023 og de nyeste modeller fra firmaer som OpenAI, Meta og Google og brugte dem til at søge på forskellige begreber og emner – både meget brede og almenkendte emner som demokrati og ligestilling, og nogle som var mere landespecifikke og snævre. Forskerne sammenlignede de svar, de modtog fra sprogmodellerne, med den information de fik ud fra en klassisk søgemaskine.
Det viste sig, at selv de bedste sprogmodeller kom med en mere snæver og et mindre diverst udpluk af viden, end hvad man får ud af en søgemaskine. Ifølge Isabelle Augenstein skyldes det den måde, en sprogmodel er bygget op på.
Det har den konsekvens, at de mindre populære påstande og kilder slet ikke dukker op i sprogmodellens svar.
Isabelle Augenstein
»Når man bruger AI-modeller som søgemaskine, får man nogle opsummeringer af et muligt svar. For modellerne er i virkeligheden bare et sofistikeret stykke statistik, som udregner sandsynligheden for det næste ord,« siger Isabelle Augenstein og fortsætter:
»Med tiden er de blevet meget bedre, og der er lagt nogle flere lag ovenpå, for eksempel at de skal generere svar, som de tror, mennesker godt kan lide; men basisteknikken er, at modellen vælger det mest sandsynlige udfald og glemmer resten.«
Modellerne er også underlagt en pladsbegrænsning, og derfor bliver de nødt til at udvælge kilder og fakta. Her prioriterer sprogmodellerne de påstande, som de finder hos de mest populære kilder.
»Det har den konsekvens, at de mindre populære påstande og kilder slet ikke dukker op i sprogmodellens svar,« siger Isabelle Augenstein.
Efterhånden er internettet allerede fyldt med tekster, som er skrevet helt eller delvist af sprogmodeller. Og det er vand på møllen for det mulige kollaps af viden:
»Mange bruger sprogmodellen til at skrive tekster. Og når man gør det, så kommer de svar ud på nettet og indgår i det, som de fremtidige sprogmodeller bliver trænet på. Når både de nye svar og den nye viden er AI-generet, kan det i sidste ende betyde, at vi får et videnskollaps,« siger Isabelle Augenstein.
Professoren understreger, at vi endnu ikke har set eksempler på et videnskollaps, og at de nye sprogmodeller er langt bedre end de gamle. Men vi skal stadig være opmærksomme på det, for alle mekanismerne er i dag på plads for, at et kollapset kan opstå:
»Når AI-modellerne allerede genbruger de tekster, som andre modeller er trænet på, fordi de ligger som kilder på nettet, så kan videnskollapset ske over tid.«
LÆS OGSÅ: KU’s AI-deklarationer sætter de studerendes retssikkerhed på spil
Og det vil have ekstra store implikationer i et land som Danmark, hvor sprogområdet er relativt småt. Det skyldes, at mængden af viden og tekster på dansk er begrænset:
»Vi kan ende med at stå i en situation, hvor små grupperingers holdninger og meninger bliver udelukket fra samfundet, fordi det ikke er muligt at finde noget viden om det.«
Firmaerne, som udvikler sprogmodellerne, har selv fokus på problematikken og arbejder på at sikre, at modellerne ikke bliver trænet på AI-genereret data. Men de er ved at løbe tør for træningsdata fra nettet, og derfor er de begyndt at opkøbe gamle bøger i stor stil, som de scanner ind, så modellerne kan træne på dem, en praksis der har været omtalt i flere medier.
»De her firmaer er meget aktive i deres forsøg på at sikre, at sprogmodellerne hele tiden tilegner sig ny viden. Derfor var jeg ikke overrasket over, at de nye sprogmodeller faktisk er bedre end de gamle,« siger Isabelle Augenstein.
Når virksomhederne bag sprogmodellerne er opmærksomme på problemet, er det muligt, at videnskollapset aldrig kommer til at ske. Men selvom Isabelle Augenstein er i tvivl om, hvorvidt vi kommer til at opleve kollapset, synes hun stadig, vi skal være bekymrede for udviklingen.
»Det handler jo om, hvad vi som mennesker selv ved, og hvordan vi får vores viden. Derfor er det vigtigt, at vi går i dybden med nogle af de søgninger, vi foretager os.«
LÆS OGSÅ: AI findes »derude«. Det betyder ikke, at den hører hjemme på universitetet
Og det kan man, ifølge professoren, gøre på forskellige måder. For eksempel ved at stille uddybende spørgsmål til sprogmodellen og bede den komme med flere kilder og påstande:
»Mange går ud fra, at sprogmodellerne genererer deres svar ud fra alle kilder på nettet, men sådan forholder det sig ikke. De genererer svar på baggrund af de mest populære kilder på nettet.«
Isabelle Augenstein fremhæver to særlige problematikker ved brugen af AI. For det første kan sprogmodellerne hallucinere og opfinde svar, som ikke er korrekte. For det andet har modellerne en indbygget bias, hvor de forsøger at please brugerne.
Det handler jo om, hvad vi som mennesker selv ved, og hvordan vi får vores viden.
Isabelle Augenstein
»Man kan ende med at overbevise sprogmodellen om, at det den siger er forkert, og så retter den ind, selvom det ikke er korrekt.«
Når Google i dag selv har indført en AI, som giver en opsummering, forværrer det, ifølge Isabelle Augenstein, problemet:
»Det kan betyde, at de fleste ender med bare at kigge på AI-opsummeringen i stedet for selv at læse selve kilderne. Man skal altid huske, at jo mindre populært det emne du undersøger er, jo vigtigere er det at kigge kilderne igennem.«
Så det er ikke fordi, du opfordrer folk til at stoppe med at bruge AI’s til informationssøgning?
»Nej, jeg tænker, den er fin til at danne et hurtigt overblik. De er jo gode til at opsummere og give korte svar. Men jeg opfordrer til, at man selv går i dybden med kilderne og ikke bare stoler blindt på sprogmodellerne.«